
供应商页面上写着支持 500 并发,真到业务高峰,任务却大面积超时——这是代理IP池使用中最常见的一幕。问题通常不在供应商虚标,而在那个数字是理想条件下的理论值:目标站点响应快、请求体很小、链路没有抖动。真实业务往往一条都不占,所以代理IP池到底能扛多少并发,最可靠的办法是自己压一次。
标称值和实测值差在哪
标称并发描述的是池子能同时维持多少条连接,回答的是”能开多少条路”;业务真正在意的是单位时间内能完成多少有效请求,回答的是”能跑完多少趟车”。两者之间隔着目标站点响应速度、请求体大小、重试比例三个变量,任何一项发生变化,实测结果都会和标称值拉开距离。
代理IP链路还要额外算上一段:请求先从本地走到出口,再由出口发往目标站,这一段的长短与稳定程度,直接影响单位时间内能完成的请求数。这也是为什么同一批代理IP资源,放在不同地区的机器上测,结果能差出一截。
理解这层差别,压测的目标就清楚了:不是要验证供应商有没有说谎,而是找到这套业务在这个池子上的真实上限与拐点。对代理IP池的管理来说,这份数据比任何宣传口径都更有用。
| 观测指标 | 看什么 | 到什么程度算到顶 |
|---|---|---|
| 并发数 | 同一时刻还在途的请求数量 | 继续加压成功率开始下滑 |
| 成功率 | 非业务性失败的占比 | 跌破业务可接受线 |
| 平均耗时 | 从发起到拿完整响应的时间 | 随并发线性拉长 |
| 失败类型 | 超时、连接被拒、限流各占多少 | 某一类突然集中出现 |
三个容易混淆的说法
并发数:同一时刻还在途、尚未拿到响应的请求数量。它不等于线程数,也不等于每秒请求数,压测时要用计数而不是靠感觉估。
拐点:并发继续往上加、成功率却开始明显下滑的那个位置。拐点才是这套业务在这个池子上的真实上限,标称值只是参考。
余量:拐点之下特意留出来的缓冲空间。日常运行不建议贴着拐点跑,留出三成左右,遇到突发抖动才有腾挪余地。
把这三个说法摆正,压测数据才有可比性。不然换个人测、换个时间段测,结果对不上,反而越测越乱。
一次压测怎么走
- 先定基线:用日常真实流量跑十分钟,记录成功率与平均耗时,作为后续对比的参照。
- 梯度加压:从基线的五成起步,每档维持三到五分钟,逐档往上加,不要一步跳到高位。
- 逐档记录:每一档都记下并发数、成功率、平均耗时、失败类型四项,档位之间留一段恢复时间。
- 定位拐点:成功率跌破可接受线、或平均耗时陡增的那一档,往上退一档就是可长期运行的容量。
需要注意的是,压测最好安排在业务低峰,并提前告知相关同事。压测流量与真实流量混在一起时数据会失真,也容易影响到正在跑的任务。
还有一点常被忽略:代理IP池的可用地址数会随时间波动,今天测出的拐点,不代表一个月之后还成立。把压测做成周期性动作——每月一次,或每次扩池之后补一次——数据才有延续性。
结果怎么用
拿到拐点之后,容量规划就有了依据:日常运行留三成余量,峰值不超过拐点的七成,超出部分靠排队或错峰消化。比起”一出问题就扩容”,按数据决策的成本更低,也更可控。
如果压测发现拐点远低于标称值,先别急着换服务商,按失败类型分组看:超时集中,多半是目标站限速或读取超时设得太短;连接被拒集中,可能是池子实际可用地址比标称少;限流集中,则要回头看请求频率是不是压得太狠。
代理IP池的扩容节奏也可以由此确定:当日常峰值逼近拐点的七成,就是该补量的时候;离得还远,就先把余量用在削峰填谷上,不必提前买单。
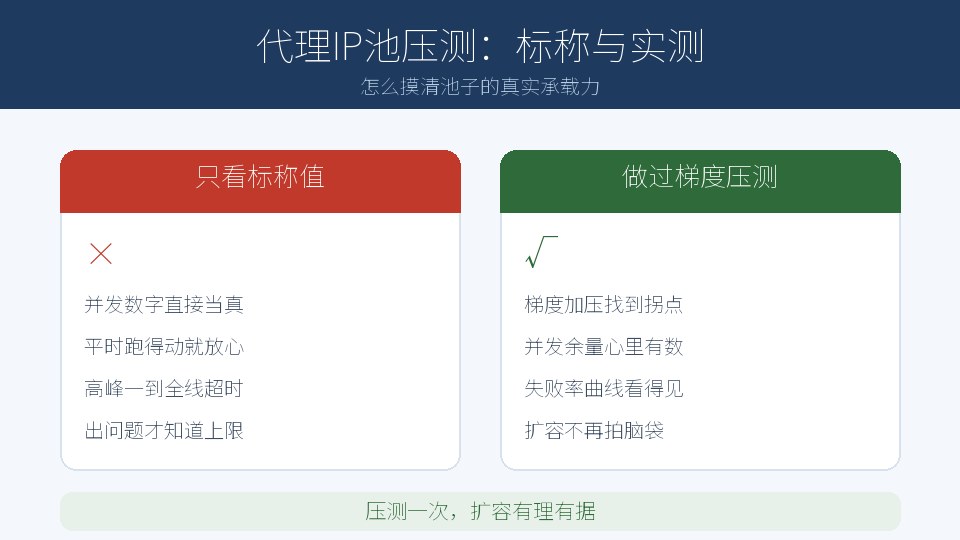
小结:代理IP池的真实承载力不看标称数字,而是靠一次梯度压测摸出来的拐点;把并发数、成功率、平均耗时、失败类型四项记全,容量规划才有依据,扩容也不用拍脑袋。